Projeto e Análise de Algoritmos I
Aula 22 - Código de Huffman
Universidade Federal do Rio Grande do Sul
Instituto de Informática
Departamento de Informática Teórica
Estes slides utilizam conteúdo adaptado da bibliografia da disciplina e também de notas de aula e slides prévios dos professores Bruno Grisci, Rodrigo Machado, André Grahl Pereira, Lucas Nunes Alegre, Marcus Ritt e Luciana Buriol.
Compressão de Dados
Armazenamento de Dados
Desde que começamos a armazenar dados, a questão do tamanho dos dados obtidos é algo de vital importância e determina
- quantas fotos podemos manter nos nossos telefones celulares
- quanto tempo vai durar o download de um dado arquivo
- quanto de espaço vai ser necessário reservar nos nossos discos rígidos
- quanto ocuparão nossos livros digitais
Tipicamente, quanto menor o tamanho da representação de um dado objeto, melhor.
Compressão de Dados
Compressão visa reduzir o tamanho de um determinado tipo de dado, de forma a ser ainda possível acessar a informação contida neste.
Tipicamente, há dois tipos de compressão:
- com perdas (lossy): tipicamente no caso de imagens e vídeos, a compressão causa perda de informação, porém esta perda pode não ser crucial frente ao ganho de espaço associado (Ex: JPEG)
- sem perdas (lossless): mantém toda a informação do arquivo original (Ex: ZIP)
Vamos, nesta aula, considerar o caso de compressão sem perdas de arquivos de texto.
Arquivos de Texto
Para armazenar texto em computadores, usamos mapeamentos de caracteres para números. Os mais importantes são:
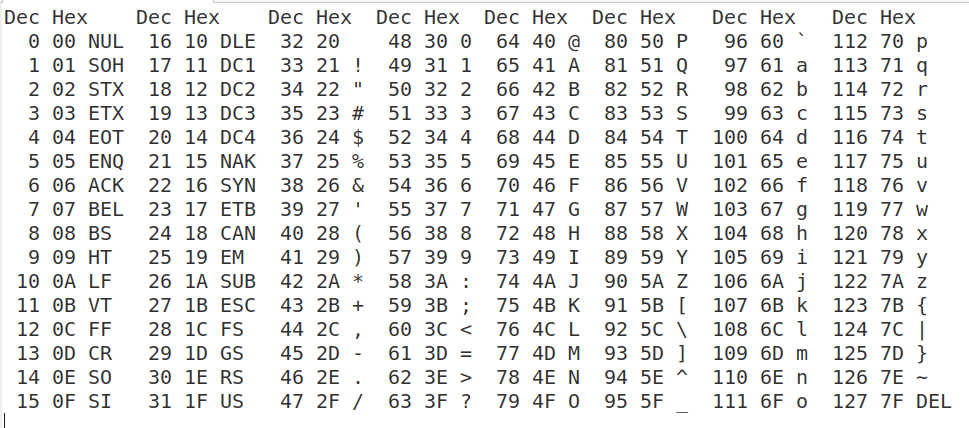
- padrão ASCII (American Standard Code for Information Interchange): 0 a 127, representa letras minúsculas, maiúsculas e símbolos de controle.
- padrão UNICODE: 0 a 1.114.111 (U+10FFFF), representa todos os sistemas de escrita das principais linguagens humanas, além de símbolos matemáticos e de controle.
Para armazenar caracteres UNICODE, existem diversas codificações:
- UTF-8 (1 a 4 bytes, tamanho variável, compatível com ASCII)
- UTF-16 (2 ou 4 bytes, tamanho variável)
- UCS-2 (2 bytes, tamanho fixo, limitado)
- UTF-32 (4 bytes, tamanho fixo)
UTF significa Unicode Transformation Format.
ASCII
UNICODE
Todos os símbolos UNICODE: symbl.cc/pt/unicode-table
Angzarr (U+237C ⍼) – Why Nobody Knows What This One Unicode Character Means:
UTF-8
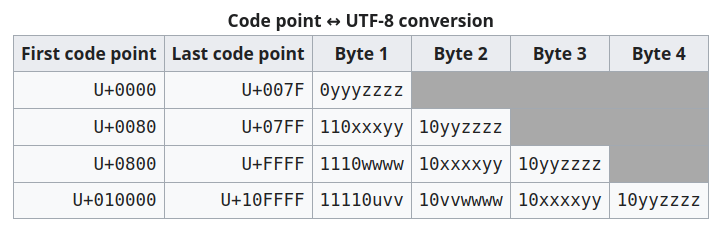
U+uvwxyz seria a palavra representada, onde u, v, w, x, y e z representam bits individuais (agrupados em 4 por caractere hexadecimal).
Exemplos:
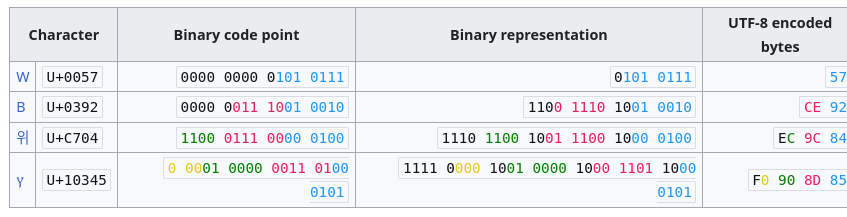
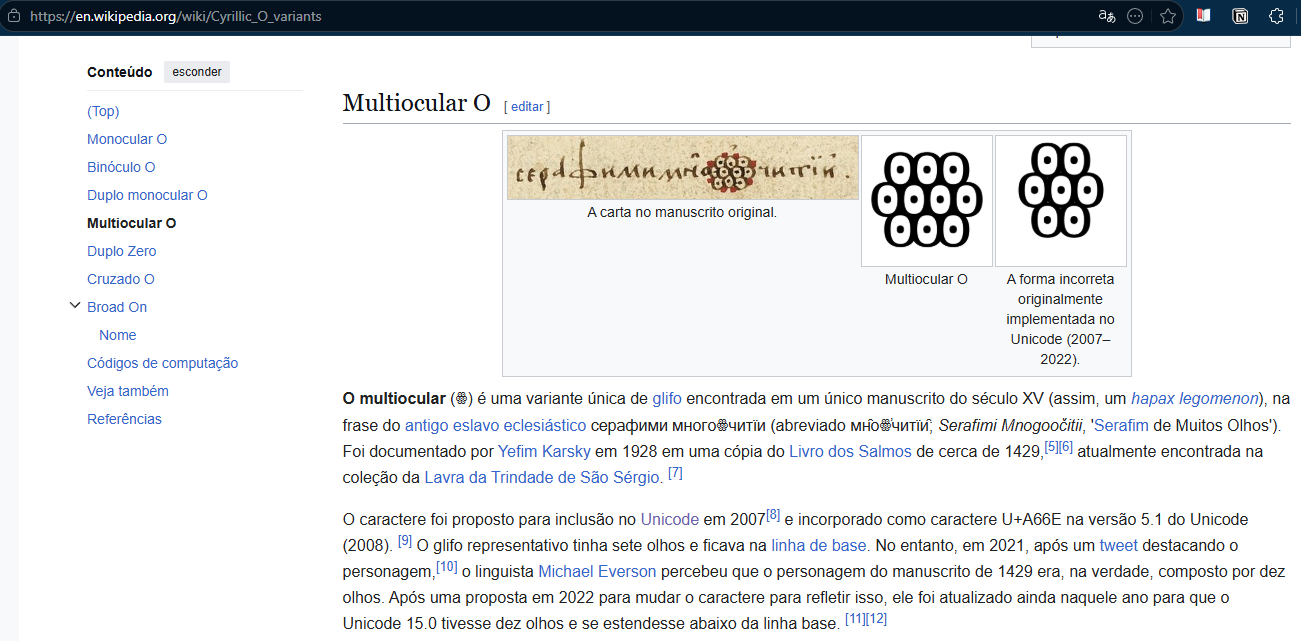
Many-Eyed Seraphim
Many-Eyed Seraphim
U+A66E ꙮ (Cyrillic Letter Multiocular O)
Codificações Prefix-Free Ótimas
Codificações de Texto
Por simplicidade, vamos começar considerando alfabetos menores e suas possíveis codificações. Considere \Sigma = \{A, B, C, D\}.
Uma possibilidade de codificação seria:
| Símbolo | Codificação |
|---|---|
| A | 00 |
| B | 01 |
| C | 10 |
| D | 11 |
Poderíamos querer reduzir o espaço utilizado tentando uma codificação de tamanho variável:
| Símbolo | Codificação |
|---|---|
| A | 0 |
| B | 01 |
| C | 10 |
| D | 1 |
Pergunta: Algum problema com a codificação de tamanho variável apresentada? Qual seria a decodificação da string 10001?
Ambígua! 10001 pode ser lida como CAB, CAAD, DAAB ou DAAAD: o código de A é prefixo do de B, e o de D é prefixo do de C.
Codificações Prefix-Free
Definição: Uma codificação de texto é prefix-free (livre de prefixo) quando, para quaisquer dois símbolos distintos a e b, a codificação de a não é prefixo da codificação de b (e vice-versa).
Se uma codificação é livre de prefixo, não há ambiguidade na decodificação.
Exemplo:
| Símbolo | Codificação |
|---|---|
| A | 0 |
| B | 10 |
| C | 110 |
| D | 111 |
Basta ler os bits até completar um código:
\underbrace{110}_{C}\;\underbrace{0}_{A}\;\underbrace{111}_{D}\;\underbrace{10}_{B}
Eficiência de uma Codificação Prefix-Free
Quando símbolos ocorrem com frequências distintas, um código prefix-free pode ser mais ou menos eficiente: quanto menos bits para representar um caractere em média, melhor.
Assuma a seguinte tabela de frequências:
| Símbolo | Frequência |
|---|---|
| A | 60% |
| B | 25% |
| C | 10% |
| D | 5% |
Podemos então comparar os dois códigos (fixo e variável):
| Símbolo | Tamanho fixo | Prefix-free (variável) |
|---|---|---|
| A | 00 |
0 |
| B | 01 |
10 |
| C | 10 |
110 |
| D | 11 |
111 |
Pergunta: Qual a média do número de bits necessário para codificar cada caractere em cada um dos códigos?
- Fixo: 2 bits por caractere.
- Variável: 0{,}60 \cdot 1 + 0{,}25 \cdot 2 + 0{,}10 \cdot 3 + 0{,}05 \cdot 3 = 1{,}55 bits por caractere.
Problema do Código Prefix-Free Ótimo
Entrada: Uma tabela de frequências não-negativas p_a para cada símbolo a de um alfabeto \Sigma de tamanho \geq 2.
Saída: Um código binário prefix-free com o menor tamanho médio de codificação (por caractere):
\sum_{a \in \Sigma} p_a \times (\text{número de bits para codificar } a).
Vamos discutir agora como representar tais códigos, e como construir um código ótimo segundo uma estratégia gulosa proposta por Huffman.
Códigos como Árvores
| Símbolo | Codificação |
|---|---|
| A | 00 |
| B | 01 |
| C | 10 |
| D | 11 |
| Símbolo | Codificação |
|---|---|
| A | 0 |
| B | 01 |
| C | 10 |
| D | 1 |
Códigos como Árvores
| Símbolo | Codificação |
|---|---|
| A | 0 |
| B | 10 |
| C | 110 |
| D | 111 |
Pergunta: Como confirmar que um código é prefix-free a partir da árvore correspondente?
Basta verificar que todos os símbolos estão em folhas. Um símbolo em um nodo interno é prefixo de todos os símbolos da sua subárvore (no slide anterior: A = 0 é prefixo de B = 01).
Códigos como Árvores: Propriedades
Proposição: Toda árvore binária com cada símbolo do alfabeto ocorrendo em no máximo um nodo corresponde a exatamente uma codificação binária do alfabeto.
- Nesta representação como árvore, a profundidade do nodo onde se encontra um determinado símbolo corresponde ao número de bits necessários para representá-lo.
- Árvores onde os símbolos ocorrem exclusivamente nas folhas correspondem a códigos prefix-free.
Problema do Código Prefix-Free Ótimo (Árvores)
Definição: Seja \Sigma-árvore uma árvore contendo cada símbolo de \Sigma em exatamente uma de suas folhas.
Entrada: Uma tabela de frequências não-negativas p_a para cada símbolo a de um alfabeto \Sigma de tamanho \geq 2.
Saída: Uma \Sigma-árvore com o menor tamanho médio de codificação (por caractere):
\sum_{a \in \Sigma} p_a \times (\text{profundidade de } a \text{ na árvore}).
Codificação de Huffman
Algoritmo de Huffman
Algoritmo de Huffman (1951): Constrói uma \Sigma-árvore ótima a partir da tabela de frequências de símbolos.
Construção é bottom-up e gulosa.
Ideia fundamental: Os caracteres que aparecem menos devem ser agrupados primeiro (pois vão ocorrer como os códigos de maior tamanho na árvore final).
Curiosidade: Esse foi um problema de sala de aula proposto pelo professor de David A. Huffman (Robert M. Fano), que tinha uma proposta top-down sub-ótima para o mesmo problema.
Algoritmo de Huffman: Aplicações
- Compressão de arquivos em formatos como ZIP, GZIP e PNG.
- Codificação eficiente de dados em sistemas de transmissão digital.
- Compressão de áudio e imagem em formatos multimídia, como MP3 e JPEG.
- Otimização da largura de banda em redes de comunicação.
- Aplicação em telecomunicações para minimizar redundâncias em mensagens.
- Emprego em compiladores e técnicas de representação compacta de símbolos.
Algoritmo de Huffman: Pseudocódigo
Entrada: alfabeto \Sigma e tabela p_a para cada símbolo a \in \Sigma.
Saída: \Sigma-árvore ótima.
Implementação em Python
Ver também: huffman.ipynb
Exemplo de Execução
Frequências: A: 60%, B: 25%, C: 10%, D: 5%.
| # | T_1 | T_2 | P(T_3) | F (pesos) |
|---|---|---|---|---|
| 1 | D\,(5) | C\,(10) | 15 | 15,\ 25,\ 60 |
| 2 | \{C,D\}\,(15) | B\,(25) | 40 | 40,\ 60 |
| 3 | \{B,C,D\}\,(40) | A\,(60) | 100 | 100 |
Outro Exemplo de Execução
Pesos: A: 3, B: 2, C: 6, D: 8, E: 2, F: 6.
| # | T_1 | T_2 | P(T_3) | F (pesos) |
|---|---|---|---|---|
| 1 | B\,(2) | E\,(2) | 4 | 3,\ 4,\ 6,\ 6,\ 8 |
| 2 | A\,(3) | \{B,E\}\,(4) | 7 | 6,\ 6,\ 7,\ 8 |
| 3 | C\,(6) | F\,(6) | 12 | 7,\ 8,\ 12 |
| 4 | \{A,B,E\}\,(7) | D\,(8) | 15 | 12,\ 15 |
| 5 | \{C,F\}\,(12) | \{A,B,E,D\}\,(15) | 27 | 27 |
Outro Exemplo de Execução: Código Ótimo
O que nos gera o seguinte código ótimo:
| Símbolo | Peso | Codificação |
|---|---|---|
| A | 3 | 000 |
| B | 2 | 0010 |
| C | 6 | 10 |
| D | 8 | 01 |
| E | 2 | 0011 |
| F | 6 | 11 |
Média de bits por símbolo: \;\dfrac{3\cdot 3 + 2\cdot 4 + 6\cdot 2 + 8\cdot 2 + 2\cdot 4 + 6\cdot 2}{27} = \dfrac{65}{27} \approx 2{,}41.
Um código de tamanho fixo precisaria de 3 bits por símbolo.
Visualização do Algoritmo de Huffman
Análise do Algoritmo de Huffman
Análise de Custo do Algoritmo de Huffman
Entrada: alfabeto \Sigma e tabela p_a para cada símbolo a \in \Sigma.
Saída: \Sigma-árvore ótima.
Seja |\Sigma| = n. Temos então que o algoritmo de Huffman, se implementado ingenuamente, possui tempo de execução O(n^2).
- Iniciamos com n árvores unitárias, e a cada passo unimos duas delas em uma. Serão ao todo n-1 unificações (passos no laço principal).
- Determinar as duas árvores de menor ocorrência (P) custa O(n) se utilizarmos vetores ou listas para F.
Contudo, se utilizarmos uma heap para F, reduzimos para O(\log n) o custo de extração das duas menores árvores, e o algoritmo fica com custo total O(n \log n).
| Estrutura para F | Linhas 6–7 | Linha 11 | Total (n-1 iterações) |
|---|---|---|---|
| vetor / lista | O(n) | O(1) | O(n^2) |
| heap | O(\log n) | O(\log n) | O(n \log n) |
Correção do Algoritmo de Huffman
Para garantir que a árvore gerada é prefix-free, basta utilizar indução:
- Árvores unitárias iniciais são prefix-free.
- A operação de composição (merge) gera árvores prefix-free.
Garantir otimalidade é um pouco mais complexo: serão somente rascunhados os principais elementos da demonstração.
Assuma que a e b são, em algum momento, os símbolos com menores pesos:
- Ideia 1: Provar que a saída do algoritmo de Huffman é ótima para toda \Sigma-árvore onde a e b são irmãos (não necessariamente ótima global).
- Ideia 2: Provar que uma dada solução ótima T pode ser convertida em uma outra solução ótima T' onde a e b são irmãos (Argumento da Troca).
Correção: Lema Auxiliar
Seja T a \Sigma-árvore gerada por Huffman para S, onde y^* e z^* são os dois símbolos de menor frequência e \omega é a meta-letra com f_\omega = f_{y^*} + f_{z^*}. Seja T' a S'-árvore obtida de T removendo as folhas y^* e z^* e renomeando o pai deles para \omega.
Notação: \text{prof}_T(a) denota a profundidade (número de bits) do símbolo a na árvore T.
Notação: \text{ABL}(T) = \sum_{a \in \Sigma} f_a \cdot \text{prof}_T(a) é o número médio de bits por letra (Average Bits per Letter) do código representado por T.
Exemplo: y^* = B, z^* = E, f_\omega = \frac{4}{27}, \;\text{ABL}(T) = \frac{65}{27} e \text{ABL}(T') = \frac{61}{27}.
Correção: Lema Auxiliar
Seja T a \Sigma-árvore gerada por Huffman para S, onde y^* e z^* são os dois símbolos de menor frequência e \omega é a meta-letra com f_\omega = f_{y^*} + f_{z^*}. Seja T' a S'-árvore obtida de T removendo as folhas y^* e z^* e renomeando o pai deles para \omega.
Lema: \text{ABL}(T') = \text{ABL}(T) - f_\omega.
Demonstração: A profundidade de cada x \neq y^*, z^* é a mesma em T e T'. As profundidades de y^* e z^* em T são cada uma exatamente 1 + a profundidade de \omega em T'. Logo:
\begin{aligned} \text{ABL}(T) &= f_{y^*} \cdot \text{prof}_T(y^*) + f_{z^*} \cdot \text{prof}_T(z^*) + \sum_{x \neq y^*, z^*} f_x \cdot \text{prof}_T(x) \\ &= (f_{y^*} + f_{z^*}) \cdot (1 + \text{prof}_{T'}(\omega)) + \sum_{x \neq y^*, z^*} f_x \cdot \text{prof}_{T'}(x) \\ &= f_\omega + f_\omega \cdot \text{prof}_{T'}(\omega) + \sum_{x \neq y^*, z^*} f_x \cdot \text{prof}_{T'}(x) \\ &= f_\omega + \sum_{x \in S'} f_x \cdot \text{prof}_{T'}(x) = f_\omega + \text{ABL}(T'). \qquad \blacksquare \end{aligned}
Correção: Otimalidade do Algoritmo de Huffman
Teorema: O código de Huffman atinge o menor número médio de bits por letra dentre todos os códigos prefix-free.
Demonstração: Por indução no tamanho do alfabeto |S|.
- Base: Para |S| = 2, o código usa 1 bit por letra – trivialmente ótimo.
- H.I.: O algoritmo é ótimo para todo alfabeto de tamanho k - 1.
- Passo (|S| = k): Seja T a árvore gerada por Huffman. Suponha, por contradição, que T não é ótima.
- Logo existe Z com \text{ABL}(Z) < \text{ABL}(T).
- Pelo Lema (4.31, ver livro), podemos assumir que y^* e z^* são irmãos em Z. Removendo-os e rotulando o pai como \omega obtemos uma S'-árvore Z'.
- Pelo lema auxiliar aplicado a Z e Z': \;\text{ABL}(Z') = \text{ABL}(Z) - f_\omega < \text{ABL}(T) - f_\omega = \text{ABL}(T').
- Isso contradiz a hipótese de indução, que garante que T' (a árvore que Huffman gera para S') é ótima para S'. \blacksquare
Conclusão
- Codificações são necessárias para podermos armazenar digitalmente textos.
- Códigos de tamanho variável podem ser mais eficientes que códigos de tamanho fixo, a depender da frequência dos caracteres utilizados.
- Códigos prefix-free podem ser visualizados como árvores binárias onde letras ocorrem somente nas folhas, sendo o tamanho do código de uma letra a sua profundidade na árvore.
- O algoritmo de Huffman gera, a partir de uma tabela de frequência, uma árvore de código prefix-free ótimo.
- O custo de execução do algoritmo de Huffman é O(n \log n) se implementado com heaps, ou O(n^2) se implementado de forma ingênua (com vetores).
?