Projeto e Análise de Algoritmos I
Aula 18 - Distância em Grafos Valorados: Heaps e Dijkstra Otimizado
Universidade Federal do Rio Grande do Sul
Instituto de Informática
Departamento de Informática Teórica
Estes slides utilizam conteúdo adaptado da bibliografia da disciplina e também de notas de aula e slides prévios dos professores Bruno Grisci, Rodrigo Machado e André Grahl.
Melhorando o Algoritmo de Dijkstra
Escolhendo a Estrutura de Dados Certa
As estruturas de dados estão em quase todos os programas. Saber quando e como usá-las é essencial para quem deseja projetar algoritmos eficientes. O objetivo de uma estrutura de dados é organizar a informação para que o acesso e a manipulação sejam rápidos e úteis.
Exemplos
Fila (Queue): usada na Busca em Largura (BFS)
Organiza os elementos em ordem sequencial, onde inserir no final e remover no início custam \mathcal{O}(1).Pilha (Stack): usada na Busca em Profundidade (DFS)
Permite inserir e remover do topo em tempo constante \mathcal{O}(1).
A escolha da estrutura certa é metade do caminho para um bom algoritmo.
Escolhendo a Estrutura de Dados Certa
Princípio da Parcimônia
Escolha a estrutura de dados mais simples que suporte todas as operações necessárias da sua aplicação.
Análise do Algoritmo de Dijkstra
P. Qual o tempo de execução? \mathcal{O}(mn).
Heaps e Fila de Prioridade
Quais as operações que precisamos?
| Operação | Tempo de Execução |
|---|---|
Inserir (Insert) |
\mathcal{O}(\log n) |
Extrair Mínimo (ExtractMin) |
\mathcal{O}(\log n) |
Encontrar Mínimo (FindMin) |
\mathcal{O}(1) |
Heapificar (Heapify) |
\mathcal{O}(n) |
Remover (Delete) |
\mathcal{O}(\log n) |
Também é possível implementar um heap para encontrar o maior valor de forma análoga.
O que Armazenar no Heap?
Ideia Intuitiva
Uma primeira ideia seria armazenar as arestas do grafo no heap, substituindo as buscas de mínimo por chamadas a
ExtractMin. Essa abordagem funciona, mas há uma versão mais simples e eficiente: armazenar os vértices.
- Embora o score de Dijkstra seja definido para arestas, o que realmente nos importa é qual vértice será processado em seguida.
- Podemos, então, usar o heap para manter diretamente o próximo vértice a ser escolhido.
Em vez de buscar a melhor aresta, buscamos diretamente o melhor vértice.
Invariante Mantido pelo Heap
Invariante
A chave (
key) de um vértice w \in V - X é o menor score de Dijkstra de uma aresta com início v \in X e fim w, ou +\infty se nenhuma aresta assim existir.
\text{key}(w) = \min_{(v, w) \in E,\; v \in X} \underbrace{\big\{\, \text{dist}(v) + \ell_{vw} \,\big\}}_{\text{score de Dijkstra}}
\text{dist}(v) é a distância do caminho mais curto de v computada em uma iteração anterior do algoritmo.
O heap mantém esse invariante durante toda a execução,
garantindo que o vértice extraído sempre tenha a menor distância atual.
Invariante Mantido pelo Heap
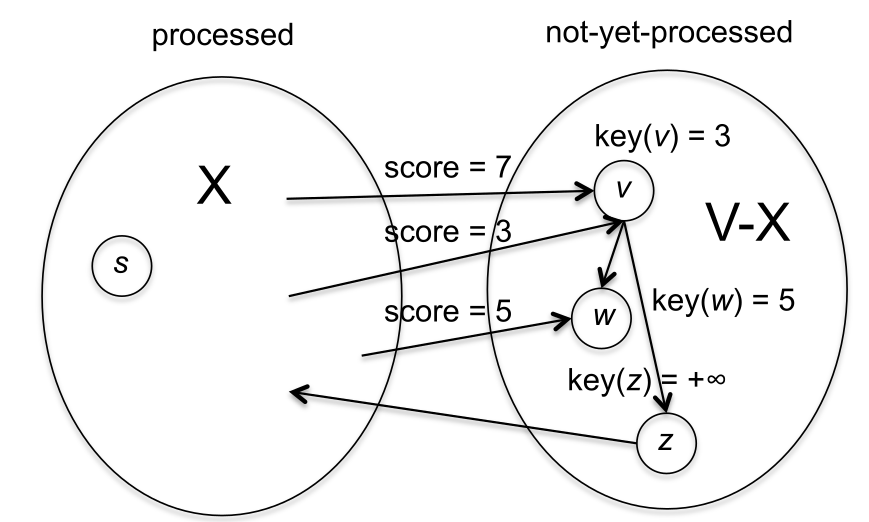
Atualização da Fronteira em Dijkstra
Mudança da Fronteira
A cada iteração, um vértice v é movido de V - X para X, alterando a fronteira:
- Arestas de X para v deixam de cruzar a fronteira.
- Arestas de v para vértices em V - X passam a cruzar a fronteira.
Consequência
O invariante exige que, para cada w \in V - X, \text{key}(w) = \min_{(u,w) \in E,\; u \in X} \underbrace{\big\{\, \text{dist}(u) + \ell_{uw} \,\big\}}_{\text{\footnotesize score de Dijkstra}} Novas arestas cruzando a fronteira podem reduzir o valor da chave de alguns vértices w.
Atualização da Fronteira em Dijkstra
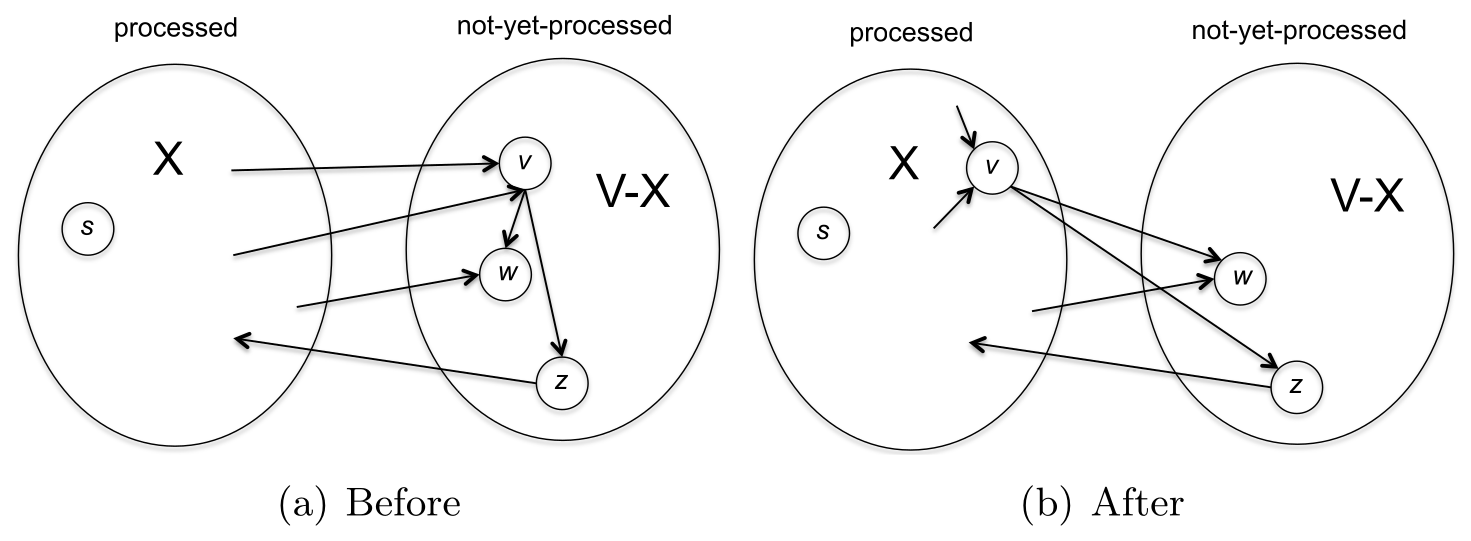
Atualização das Chaves no Heap
Quando um vértice w^* entra em X
- As novas arestas cruzando a fronteira partem de w^*.
- Basta percorrer a lista de adjacência de w^* e verificar cada aresta (w^*, y).
- Para cada y \in V - X: \text{key}(y) \gets \min\{\text{key}(y),\; \text{dist}(w^*) + \ell_{w^*y}\}
Como diminuir uma chave no heap?
- Remova o elemento com
Delete;- Atualize seu valor de
key;- Reinsira com
Insert.
Algoritmo de Dijkstra com Fila de Prioridade
Custo das Operações no Heap
Observação Importante
Quase todo o trabalho na versão com heap do algoritmo de Dijkstra é feito por operações de heap. Cada operação custa \mathcal{O}(\log n), onde n é o número de vértices. O heap nunca contém mais do que n - 1 elementos.
- Linhas 6 a 8 executam n - 1 vezes (uma por vértice, exceto s);
- Linhas 13 a 15 podem ser executadas até n - 1 vezes por iteração, uma por aresta de saída de w^*;
- Isso parece levar a um total quadrático de operações em grafos densos.
Mas podemos analisar isso de forma mais precisa…
Contagem de Operações e Complexidade Final
Responsabilidade por Arestas
Cada aresta (v, w) é processada no máximo uma vez: quando v é extraído do heap e movido de V - X para X.
- Linhas 13 a 15 são executadas no máximo uma vez por aresta;
- Total: 2m operações de heap (no máximo).
Complexidade Total
\text{Número total de operações de heap: } \mathcal{O}(m + n) \text{Custo por operação: } \mathcal{O}(\log n) \Rightarrow \text{Tempo total: } \boxed{\mathcal{O}((m + n)\log n)}
Mais rápido que \mathcal{O}(mn) da implementação direta!
Análise de Complexidade
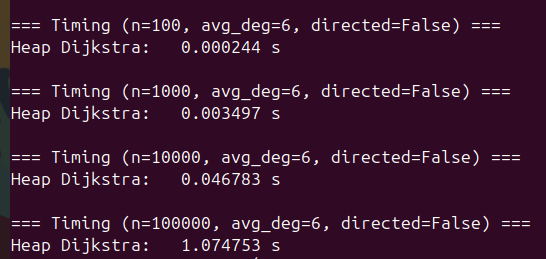
Python 3.12.3, Ubuntu 24.04.2 LTS, Intel® Core™ i7-4810MQ × 8
Heaps
Heaps como Árvores
Conceito
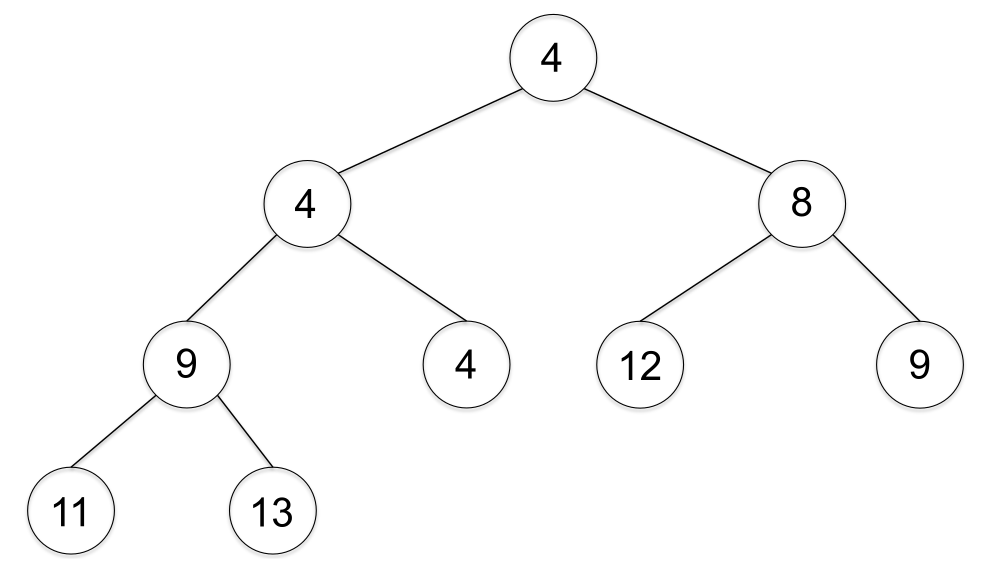
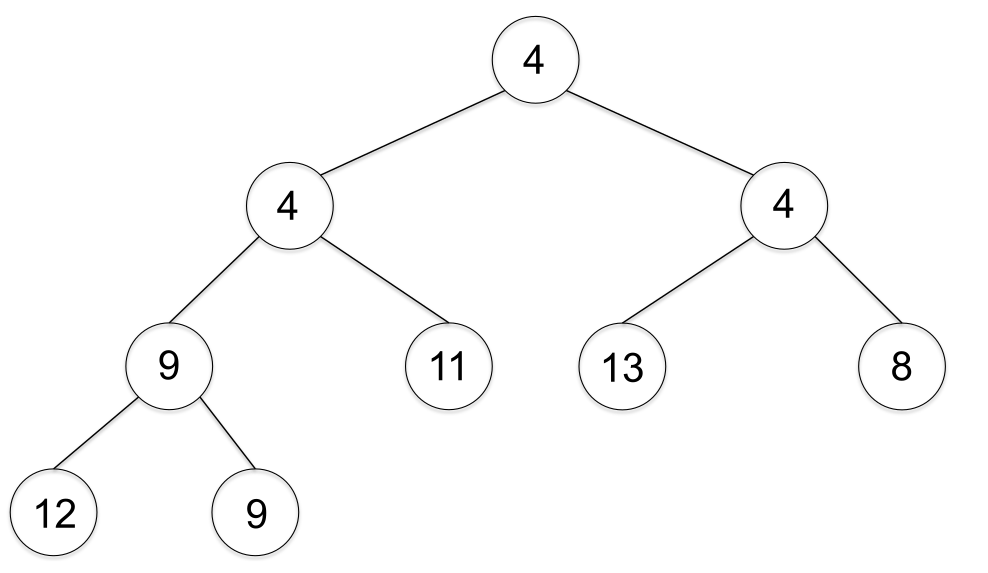
Um heap pode ser visto como uma árvore binária enraizada, em que cada nó possui 0, 1 ou 2 filhos, e cada nível é preenchido o máximo possível.
Organização dos Níveis
- Quando o número de elementos é uma unidade a menos que uma potência de 2, todos os níveis estão completos.
- Caso contrário, apenas o último nível pode estar incompleto, preenchido da esquerda para a direita.
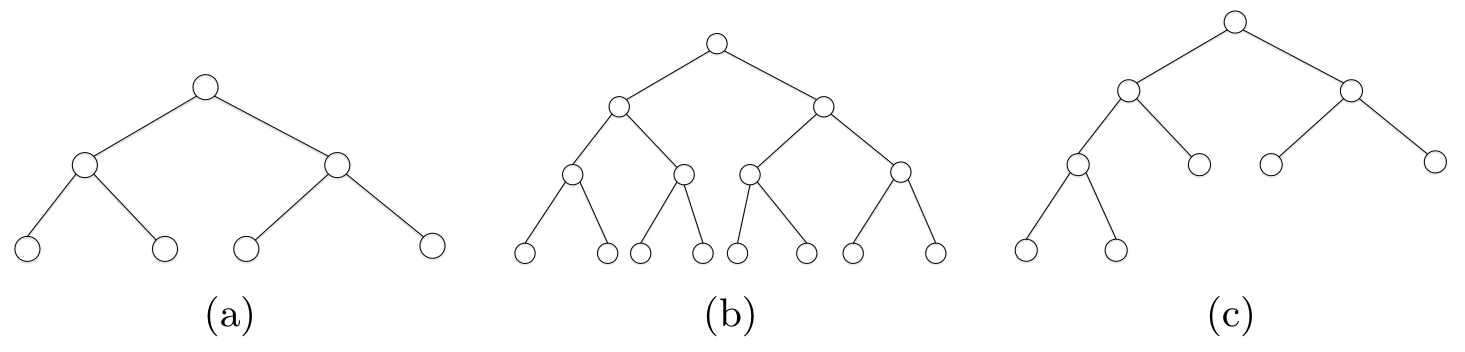
Heaps como Árvores
A Propriedade dos Heaps
Para cada objeto x, a chave de x é menor ou igual às chaves dos seus filhos.
Heaps como Vetores
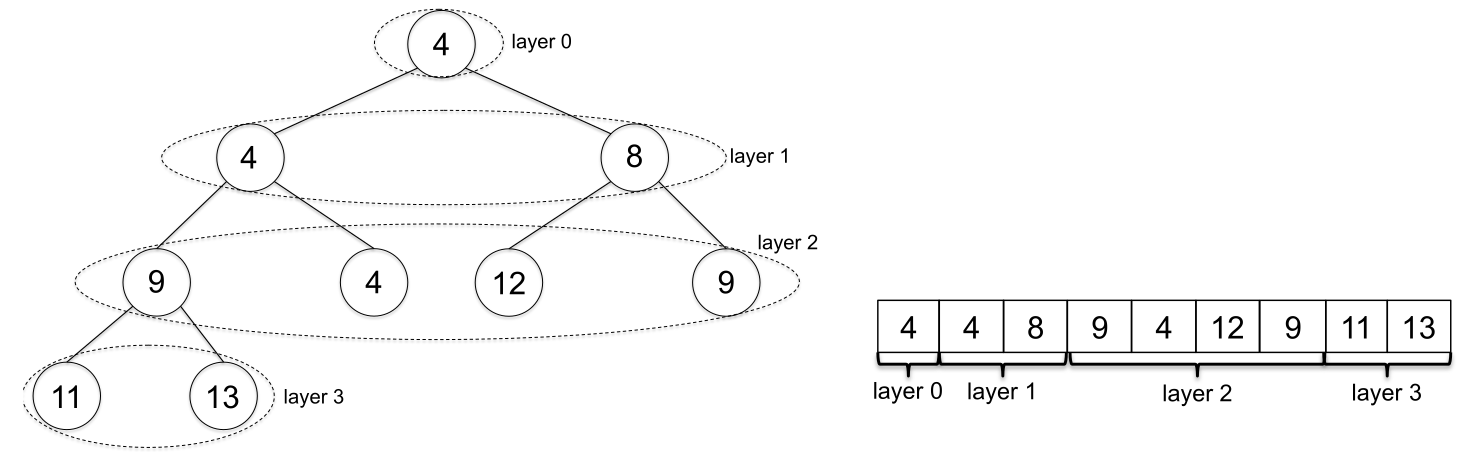
| Elemento | Posição no Vetor (começando em 1) |
|---|---|
| Pai de i | \lfloor i/2 \rfloor (para i \geq 2) |
| Filho esquerdo de i | 2i (se 2i \leq n) |
| Filho direito de i | 2i + 1 (se 2i + 1 \leq n) |
Desafio: Manter o Heap Correto e Completo
O Desafio
Ao inserir ou remover um elemento, é preciso:
- Manter a árvore completa (ou o mais cheia possível);
- Preservar a propriedade de heap, corrigindo violações quando surgirem.
Estratégia Geral
Mantenha a árvore cheia da forma mais óbvia e depois conserte locais que violam a propriedade de heap.
Implementando Insert
Operação
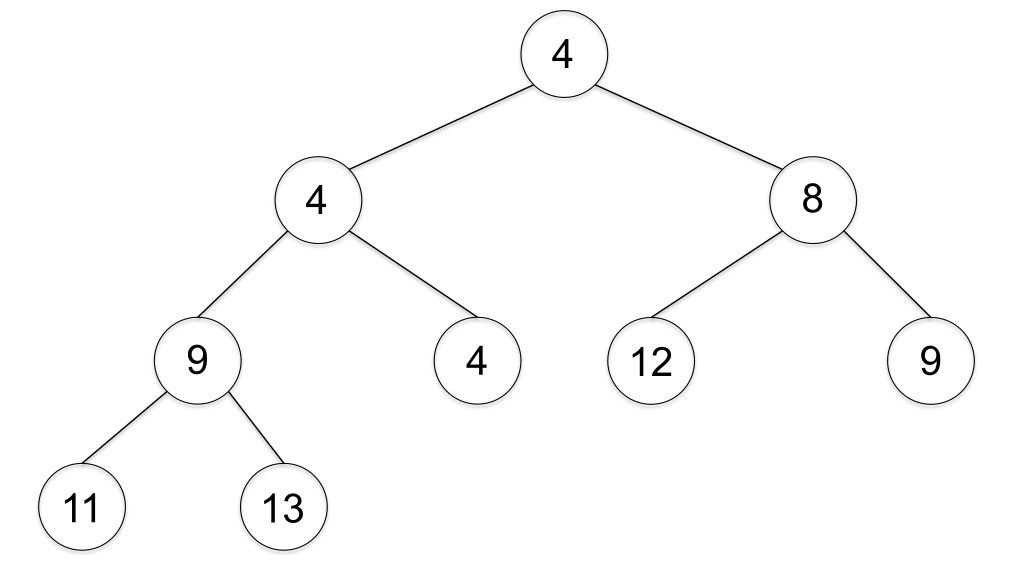
InsertDado um heap H e um novo elemento x, adicione x a H respeitando essas duas regras.
- Adicione o novo objeto ao final do heap e aumente o tamanho do heap.
- Repetidamente troque o novo objeto pelo seu pai até a propriedade de heap ser restaurada.
Insert: Exemplo
Insert: Exemplo
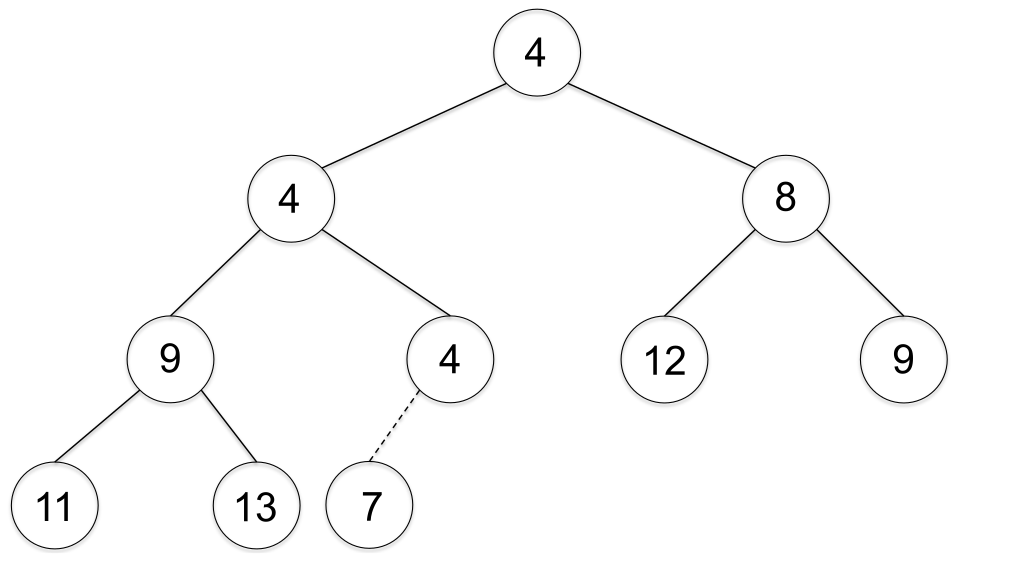
Insert: Exemplo
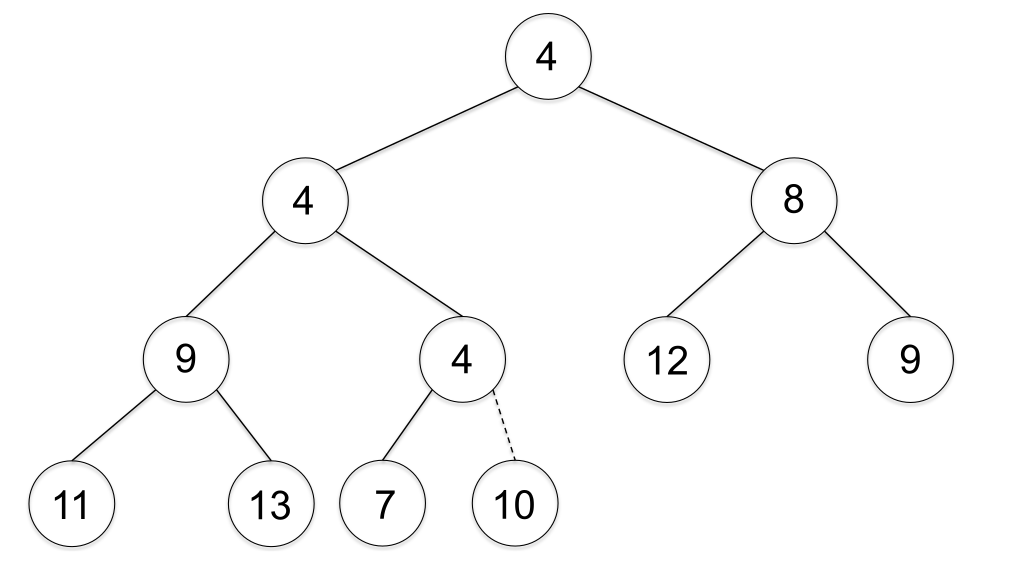
Insert: Exemplo
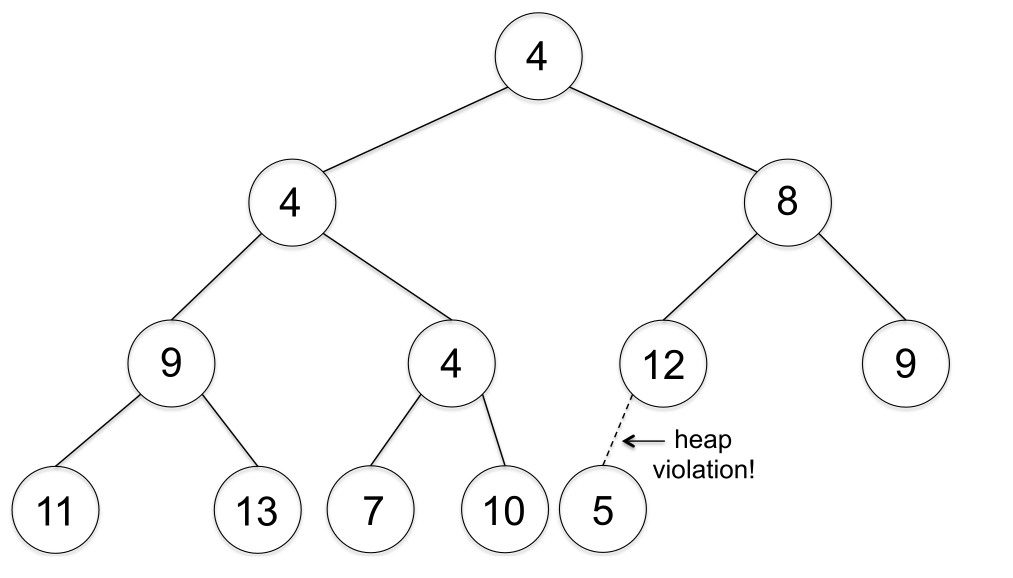
Insert: Exemplo
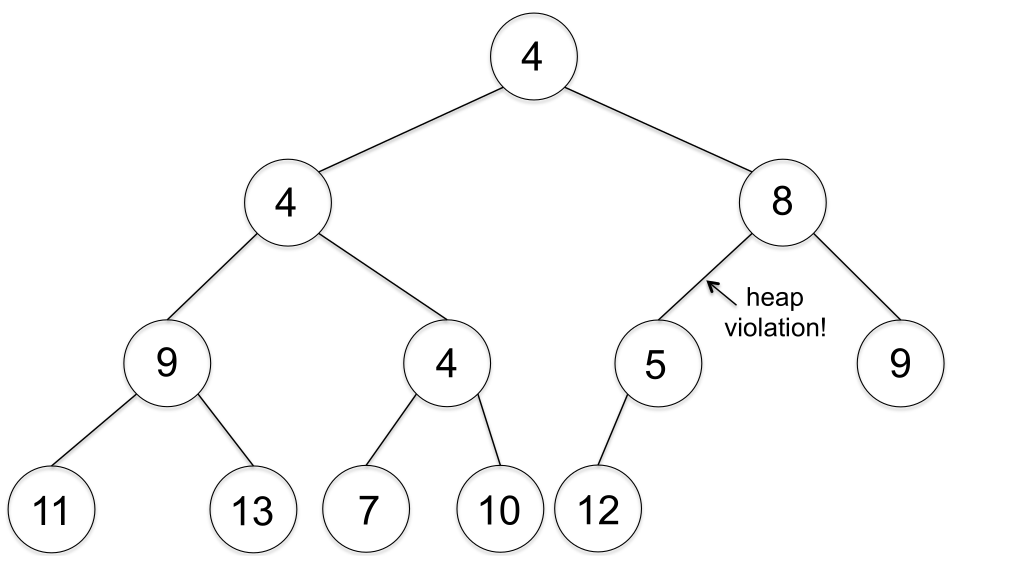
Insert: Exemplo
Operações Insert e SiftUp em um Heap
Cada troca reduz o índice pela metade, garantindo tempo total \mathcal{O}(\log n).
Cada troca pode empurrar a violação da propriedade de heap para cima. Por que não para baixo?
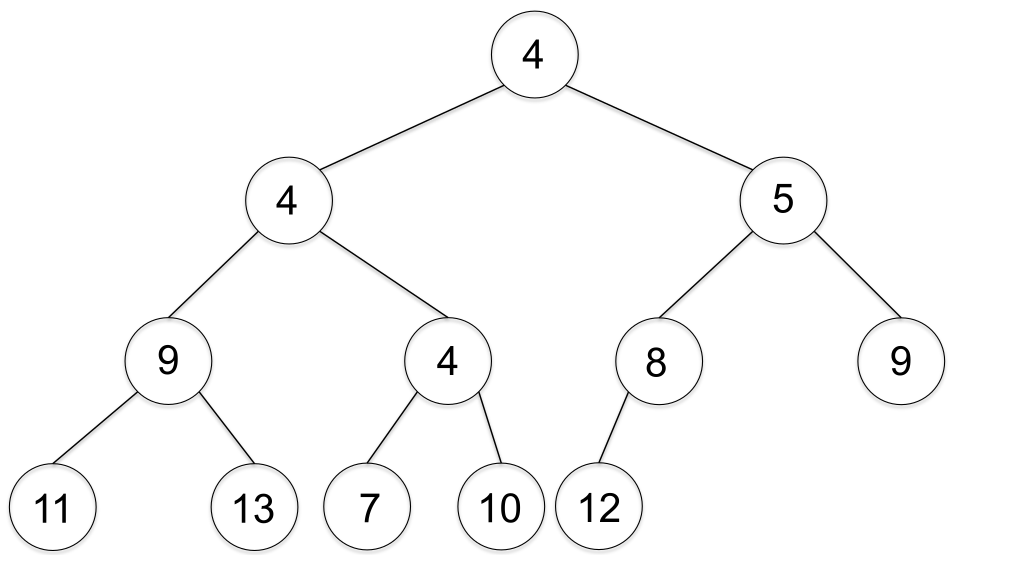
Implementando ExtractMin
Operação
ExtractMinDado um heap H, remova e devolva de H um objeto com a menor chave.
O Mínimo
A raiz de um heap é sempre o elemento mínimo. Ao removê-la, precisamos restaurar as propriedades:
- A árvore deve continuar binária completa;
- A propriedade de heap deve ser mantida.
Estratégia
Assim como na operação
Insert, seguimos o método mais direto:
- Pegamos o último nó da árvore;
- Colocamos seu valor na posição da raiz (substituindo o antigo mínimo);
- Em seguida, corrigimos possíveis violações da propriedade de heap.
ExtractMin: Exemplo
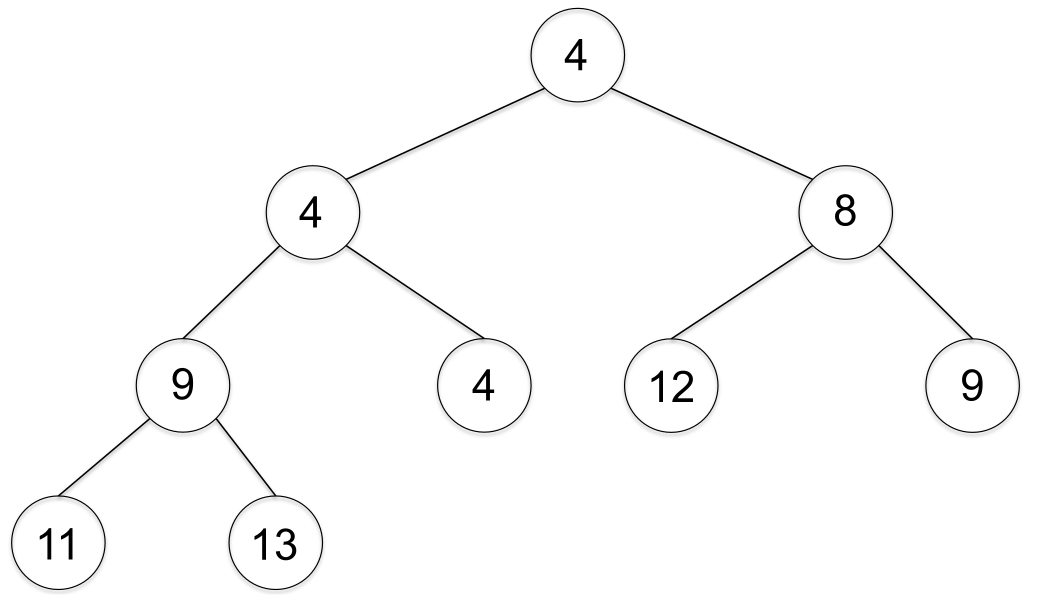
ExtractMin: Exemplo
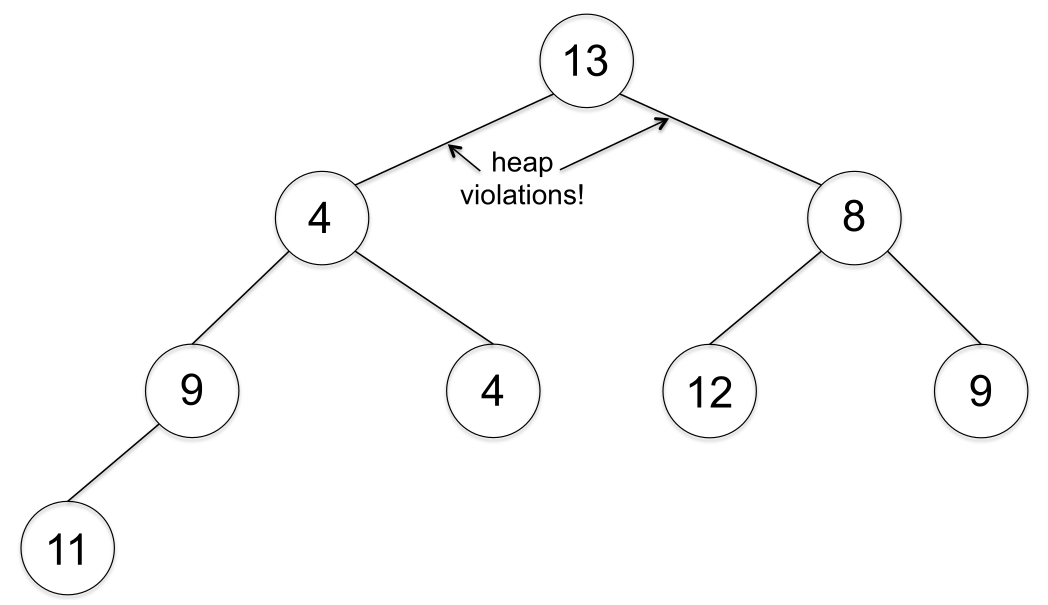
Duas violações. Qual escolher? Sempre trocar com o menor valor!
ExtractMin: Exemplo
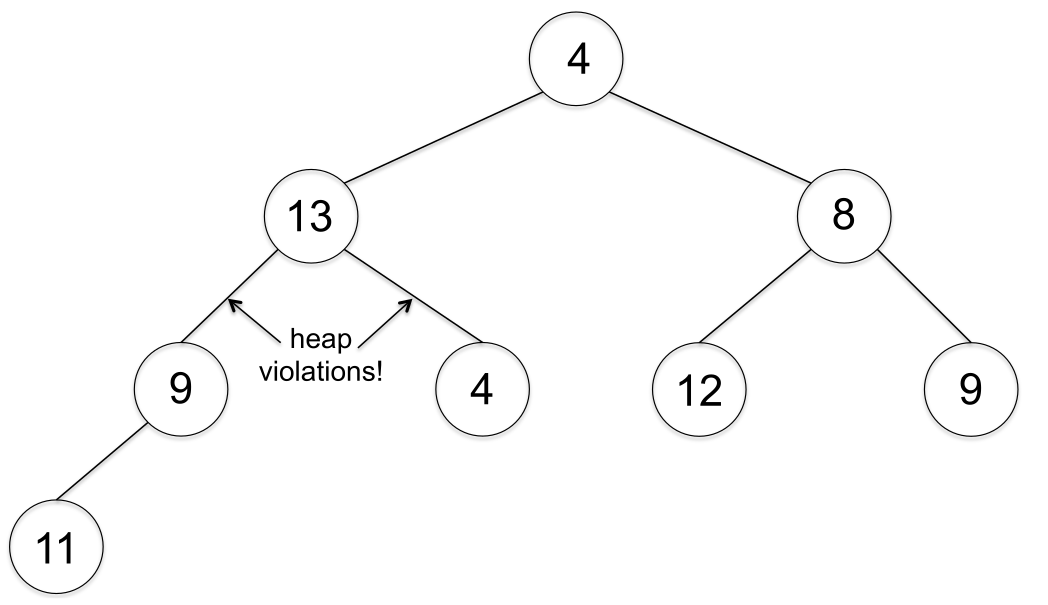
ExtractMin: Exemplo
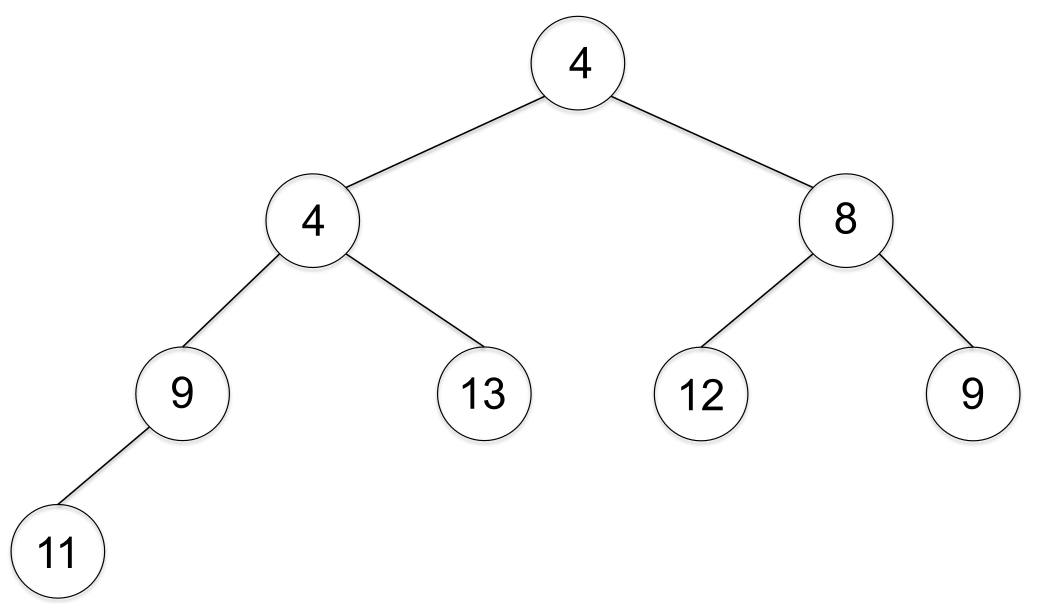
Operações ExtractMin e SiftDown em um Heap
Operações ExtractMin e SiftDown em um Heap
SiftDown — min-heap, índices a partir de 1:
Cada troca reduz o nível da árvore, garantindo tempo total \mathcal{O}(\log n).
Durante o SiftDown, no máximo dois pares pai–filho violam a propriedade de heap; cada troca empurra o nó uma camada para baixo até que ele alcance o último nível (ou antes), e os demais pares permanecem válidos, garantindo término e corretude.
HeapSort
Ordenando Vetores com Heaps
Tempo: \Theta(n^2)
Ordenando Vetores com Heaps
Complexidade
O trabalho do HeapSort se resume a 2n operações sobre um heap de no máximo n elementos. Cada operação custa \mathcal{O}(\log n), resultando em tempo total \mathcal{O}(n \log n). Além disso, o vetor B não seria necessário e as linhas 4 a 5 poderiam ser substituídas por
Heapify.
Desafio: Entendendo o Heapify
O que o HeapSort faz?
O HeapSort ordena um vetor inserindo seus elementos em um heap e removendo-os em ordem crescente.
Lembrando…
- Heapify transforma um vetor qualquer (não ordenado) em um heap válido.
- Cada operação de heap (
Insert,ExtractMin) custa \mathcal{O}(\log n).- O HeapSort completo tem complexidade \mathcal{O}(n \log n).
Desafio
Se o HeapSort é \mathcal{O}(n \log n), como o Heapify pode ser \mathcal{O}(n)?
Mais
Além de Dijkstra
Além de Dijkstra
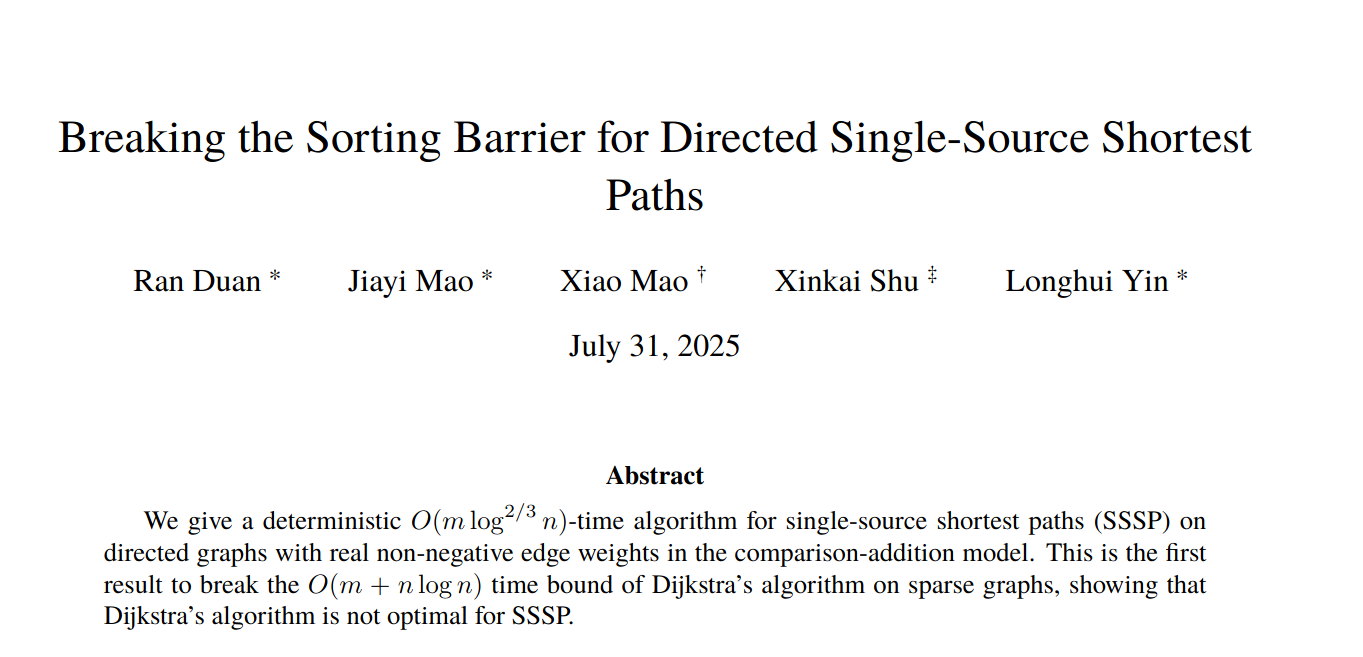
?